使い方と考え方
文字起こしを、研究の準備段階で終わらせない
Humanitext OCR は、画像やPDFを読み取り、テキストとして扱える資料へ変えるためのAI OCRです。縦書き、旧字体、手書きを含む資料、多言語が混在する紙面、段組や注の多い学術書など、一般的なOCRでは崩れやすい文書にも、資料の文脈を考慮して対応します。
目的は、認識率の数字を競うことだけではありません。大量のPDFを処理し、原画像と照合しながら直し、検索可能なPDFや統合テキストとして持ち帰るところまでを、一つの作業環境にまとめています。
まず1ページで試す
- Googleアカウントでログインし、画像またはPDFを追加します。
- 文書の種類と読み取り方を選び、必要なら「脚注を除き本文だけ」「表はJSON形式で」などの指示を書きます。
- テストページで結果を確認してから、全体の処理を開始します。
- 完了後、ページ別テキスト、統合テキスト、JSON、検索可能PDFなどをダウンロードします。
毎月の無料枠が用意されているため、最初から大きな資料を送る必要はありません。まず代表的な1ページで、紙面の癖と指示の効き方を確かめるのがおすすめです。利用枠と料金はアプリ内に最新情報を表示しています。
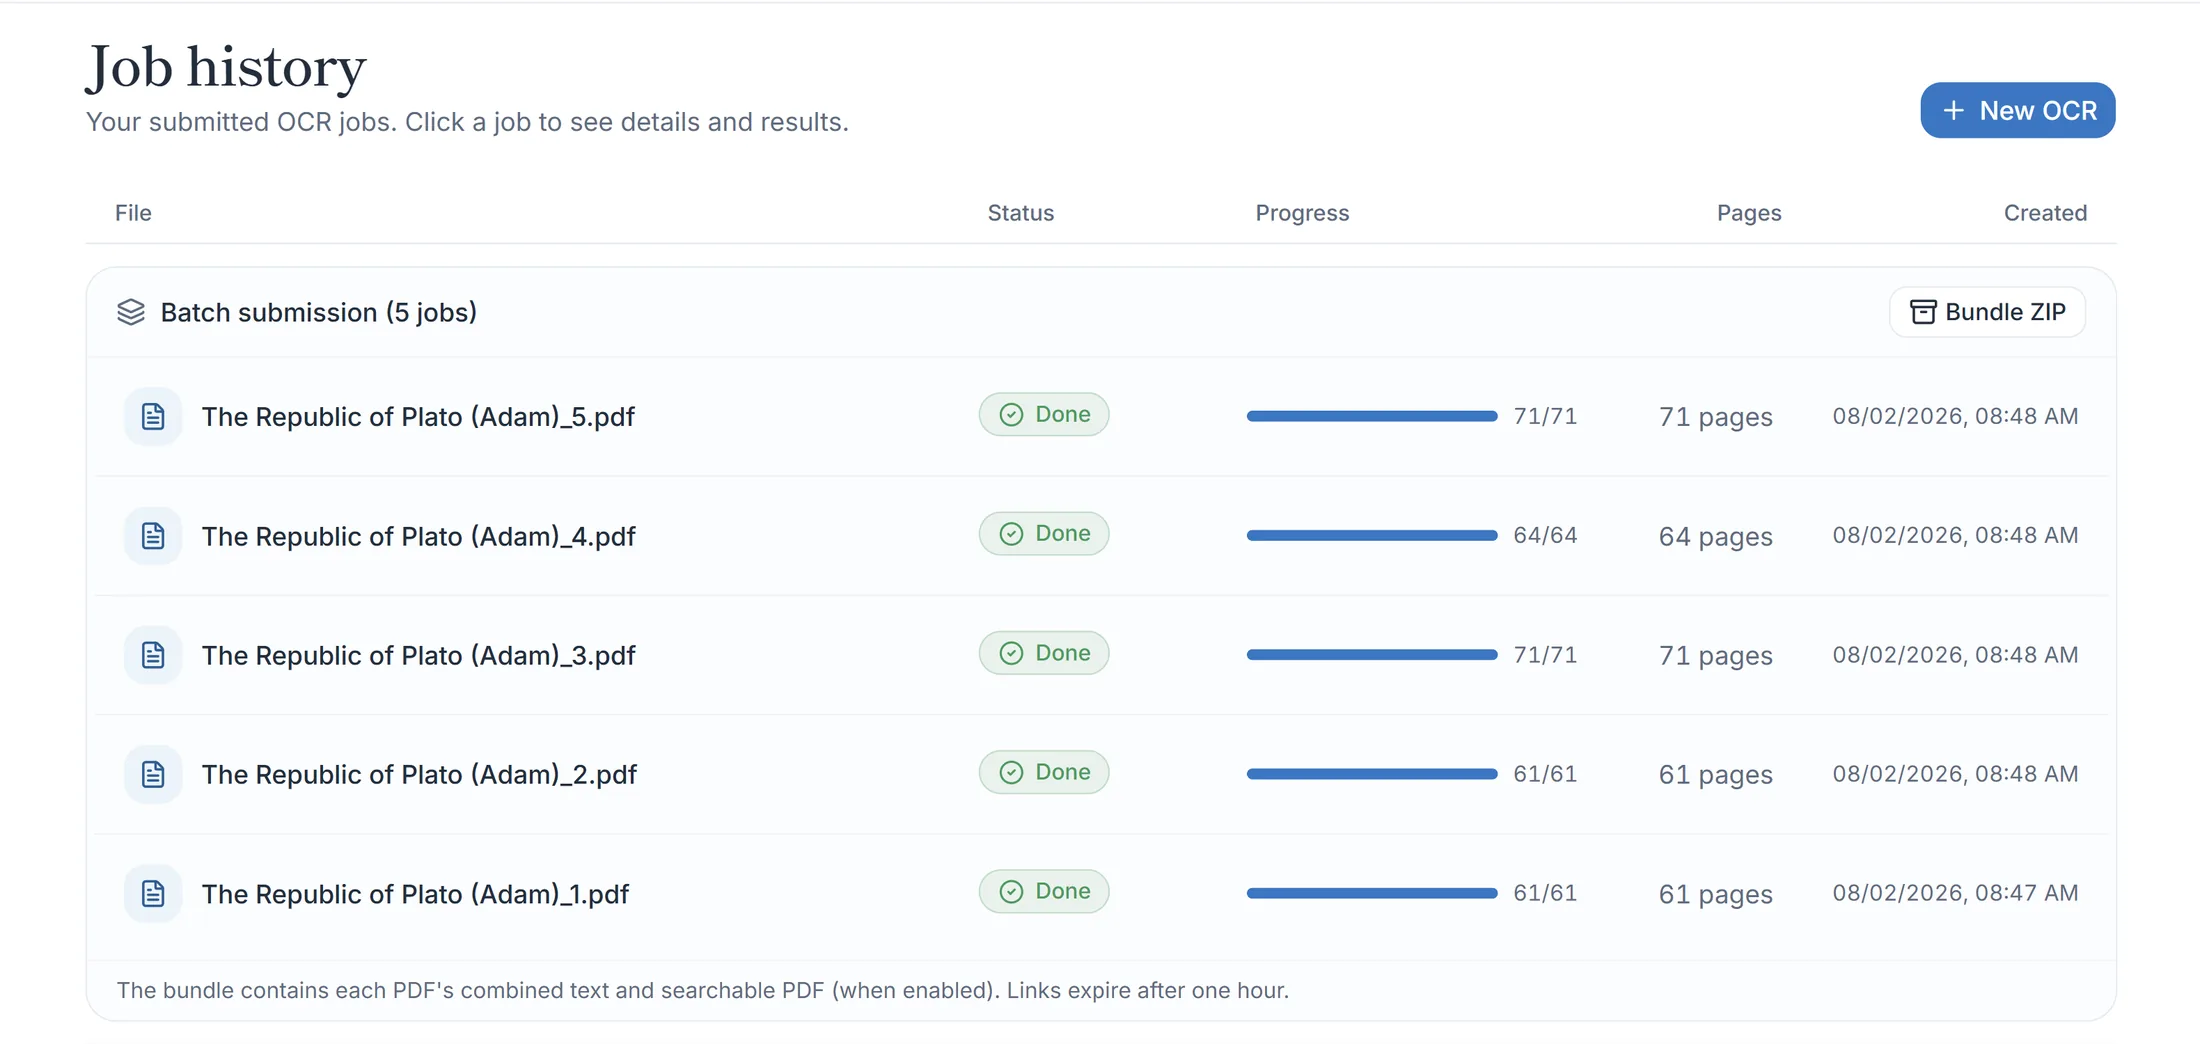
複数のPDFも、処理中の画面に縛られない
一度に最大50件のPDFを送信できます。処理はクラウド上のジョブとして続くため、タブやブラウザを閉じてもかまいません。履歴画面で進捗と結果を確認し、複数ファイルの成果物をまとめてZIPで取得できます。大量資料向けのバッチモードでは、通常より少ない利用枠で処理できます。
原画像を見ながら、行単位で校正する
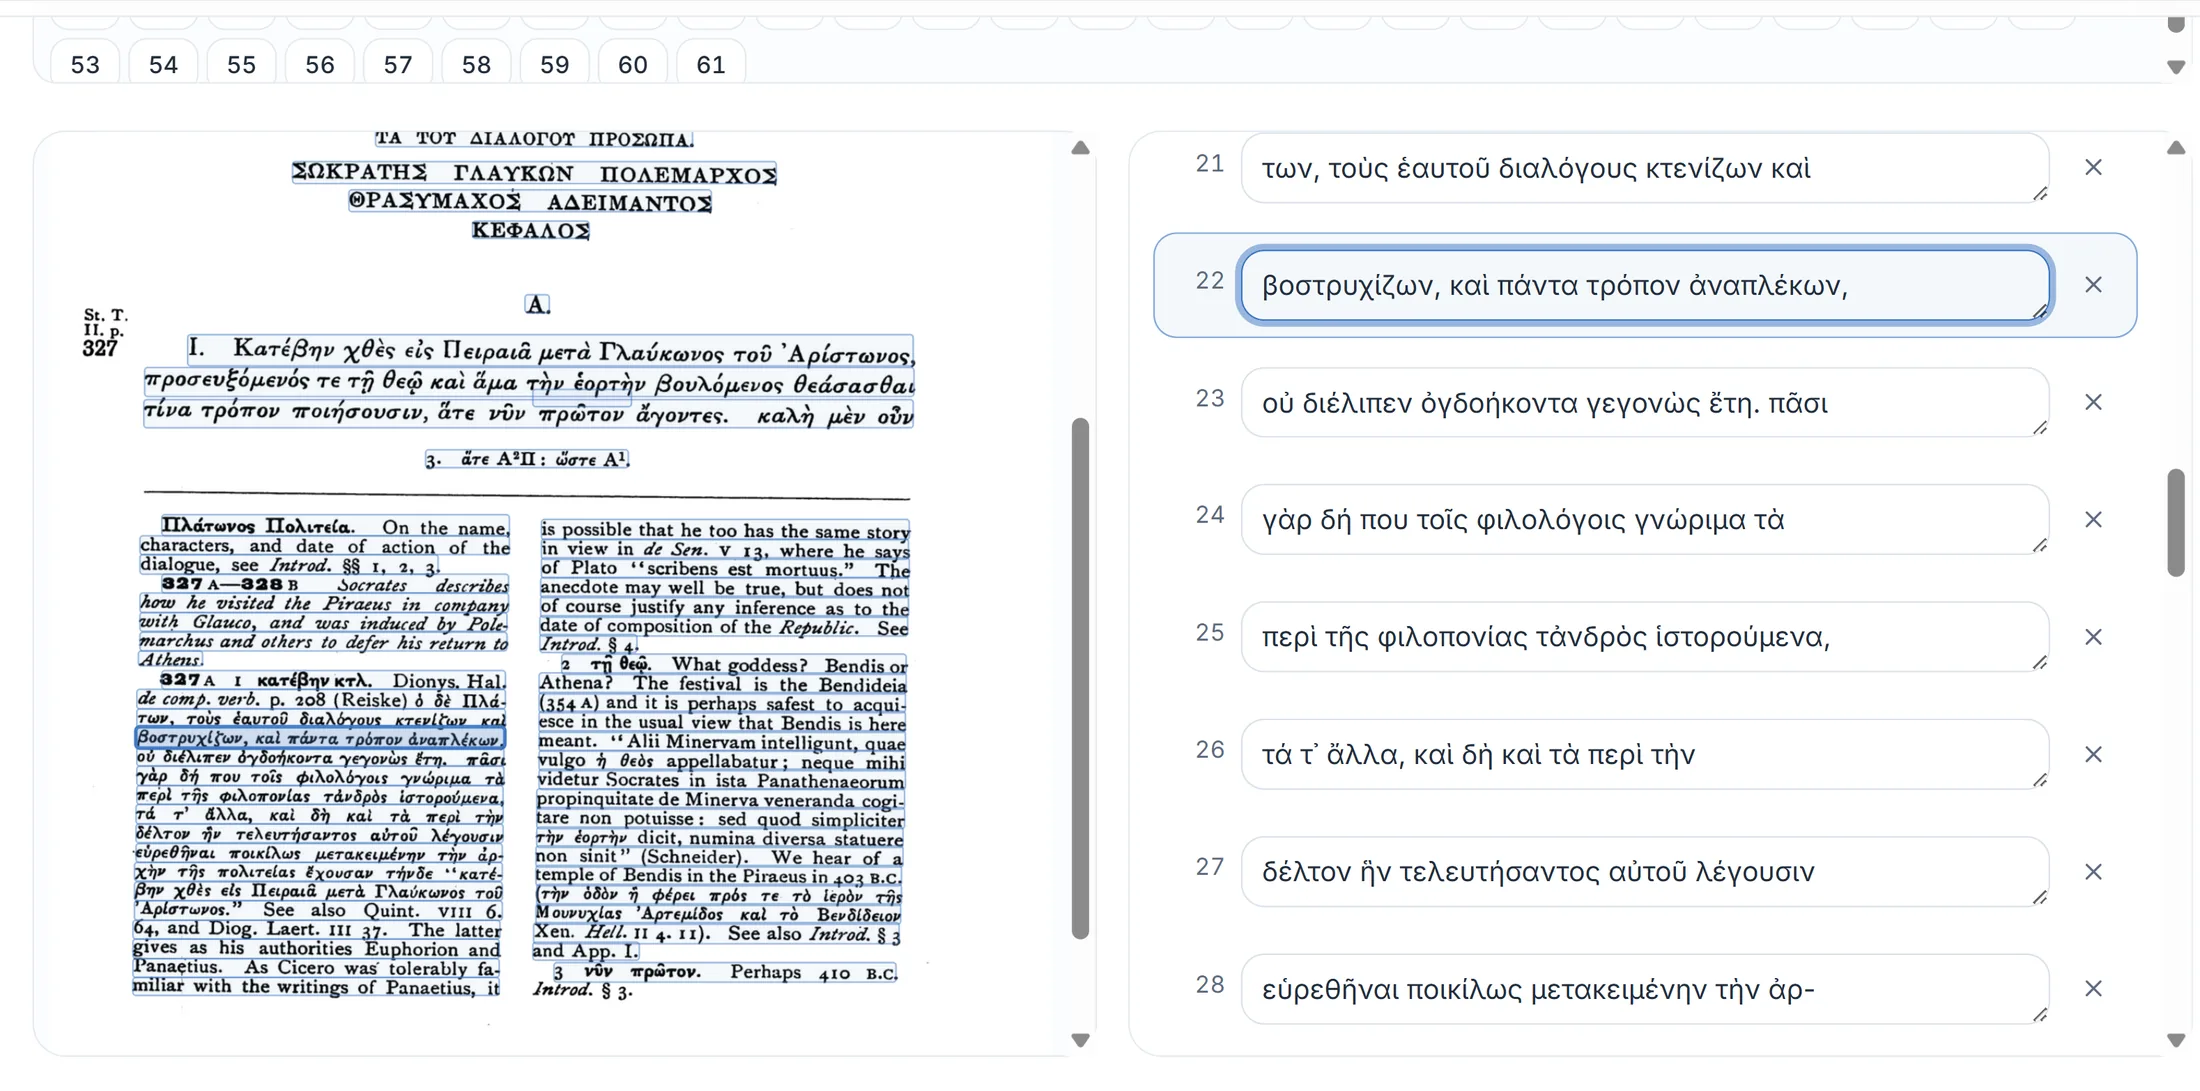
校正ビューでは、原画像と認識結果を左右に並べます。テキストの行を選ぶと対応する画像上の位置が示されるので、小さな異体字や行の取り違えを探しやすくなります。修正は統合テキストと検索可能PDFにも反映されます。
読めるPDFから、調べられるPDFへ
検索可能PDFは、元のページ画像の見た目と解像度を保ちながら、透明なテキスト層を重ねます。縦書き・横書きを自動判定し、文字列の検索やコピーができるようになります。冊子の外観を残したまま全文検索したいときや、引用候補を横断して探したいときに役立ちます。
AI OCRにも誤読はあります。固有名詞、数字、判読の難しい箇所を含む成果物を公開・引用する場合は、必ず原画像と照合してください。Humanitext OCR は校訂判断を代行するものではなく、その判断に時間を使うための下ごしらえを引き受ける道具です。
実際の画面で、最初の一歩を。
問いを一つ、作品を一篇、資料を一ページ。小さく試すところから始められます。